
Nemotron Transcribe: lokales Audio, aufnahmeweiter Kontext
Akustik- und Sprechermerkmale in eine Sprachsequenz verfolgen; Alignment und Audit-Entscheidungen getrennt halten.
KI-gestützte Lernvisualisierung · schematische Erklärung zum Artikel
Zwei Perception-Zweige liefern Akustikinhalt und Sprecheraktivität. Ihre Fusion erzeugt keine zusätzlichen Zeitpositionen je Sprecher.
KI-Hinweis: Text und erklärende Diagramme wurden mit Unterstützung generativer KI erstellt. Redaktionell verantwortlich: Florian Zimmermeister (flozi00). KI-Transparenz.
Ein Sprachmodell kann mehr liefern als ein weiteres Transkript. Es kann auch eine zweite Einschätzung zu einer vorhandenen Annotation geben: Fehlt Gesprochenes im Label, ist eine Zahl falsch oder unterscheidet sich lediglich gesprochene von geschriebener Form?
NVIDIAs Nemotron 3.5 Transcribe, veröffentlicht am 28. Oktober 2026, ist dafür interessant, weil es instruktionsgesteuerte Transkription, Sprecherzuordnung, Übersetzung und Fragen zum Audio kombiniert. Dieser Artikel erklärt die veröffentlichte Architektur und schlägt darauf aufbauend ein Datensatz-Audit vor. Dieses Verfahren ist ein Engineering-Vorschlag, kein veröffentlichter Qualitätsklassifikations-Benchmark und keine Behauptung, der Checkpoint besitze einen kalibrierten Qualitäts-Head für Audio-Text-Paare.1
NVIDIAs Launch-Korrespondenz und Pre-Brief-PDFs dienten zum Auffinden und Gegenprüfen der Release-Unterlagen. Die unten verlinkten Quellen sind öffentlich; private Nachrichten, Kontakte und Reviewer-Assets werden nicht reproduziert. Für diesen Artikel wurden weder Modellinferenz noch Korpus-Audit oder Durchsatzbenchmark ausgeführt. Quellenstand: Model Card und exportierte Konfigurationen in Revision c421d6a, der technische Bericht vom 28. Oktober, NeMo Speech 7b05f096d54db47078fd1569a54d1f3ba4a4c51f und NeMo Curator fdee8f8884cd0104772183c7938c56dbaf30841c. Die folgenden Architekturrechnungen sind daraus hergeleitet, keine gemessenen GPU-Allokationen.
Zuerst das richtige Nemotron identifizieren
Der Checkpoint heißt nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B. Er ist ein Offline-Audio-zu-Text-Modell, nicht das separate 0,6B-Modell Nemotron 3.5 ASR für Streaming und auch kein Sprachsynthesizer. Gestreamter Ausgabetext zu einer fertigen Aufnahme ist kein kausales Mikrofon-Streaming.
Die veröffentlichten Aufgabengrenzen sind entscheidend:
| Aufgabe | Release-Umfang | Praktische Grenze |
|---|---|---|
| Transkription | 40 Sprachen einschließlich Code-Switching | Akzente, Fachsprache und Transkriptkonvention prüfen |
| Übersetzung | 31 Sprachen zu/von Englisch | Keine Zusage für beliebige Sprachpaare |
| Sprecherbezogene Transkription | 13 Sprachen, bis zu acht Sprecher | Sprechernummern sind lokale Labels, keine bestätigten Identitäten |
| Fragen zum Audio | Auf Englisch trainiert | Antworten weiterhin mit der Aufnahme abgleichen |
| Lange Aufnahmen | Bis zu eine Stunde; 65.536 Kontextpositionen | Audio, Instruktion und Ausgabe teilen sich das Budget |
| Wortzeitstempel | Separater CTC-Alignment-Pfad | Ein Alignment beweist nicht, dass ein Wort tatsächlich gesagt wurde |
Deutsch wird für Transkription, Übersetzung mit Englisch und Sprecherlabels unterstützt. Für Deployment-Entscheidungen zählt die Aufgaben-Sprach-Matrix und nicht nur die größte Sprachzahl. Der Release bietet BF16-, FP8- und NVFP4-Optionen unter OpenMDW-1.1-Bedingungen. Maßgeblich sind die tatsächliche Variante und eine kompatible Runtime, nicht der Familienname als vermeintliches Speicherbudget.1
Wie Audio und Sprecher das Sprachmodell erreichen
Dies ist ein um Spracheingaben erweitertes Decoder-only-Sprachmodell, kein herkömmlicher ASR-Decoder, dessen Transkript anschließend ein Text-LLM erhält. Das Sprachmodell bekommt kontinuierliche akustische Embeddings in seiner Eingabesequenz; ein vorläufiges Transkript ist nicht der Informationsengpass. Der Parallel Expert Encoder hat zwei Perception-Zweige: einen ASR-Transformer mit ungefähr 600M Parametern und das ungefähr 99M Parameter große Sprechermodell Nemotron 3 Diarization/Sortformer. Diese beiden Experten sind von den gerouteten MoE-Experten im Sprachmodell zu unterscheiden.2
Das exportierte Frontend decodiert eine Mono-Wellenform mit 16 kHz und berechnet 128 Log-Mel-Merkmale mit einem 25-ms-Hann-Fenster, einer 512-Punkte-FFT und 10 ms Schrittweite. Der ASR-Zweig stapelt acht aufeinanderfolgende Merkmalsframes und projiziert sie auf Breite 1.280. Darauf folgen 32 Transformer-Layer mit zehn Attention-Heads, QK-Normalisierung, FFN-Expansion vier und Rotary Position Embeddings. Frame Stacking reduziert die zeitliche Rate von ungefähr 100 Frames/s auf 12,5 Embeddings/s, also 80 ms pro Position. Das sind kontinuierliche Vektoren auf LLM-Positionen: keine diskreten Audiocodec-Token, keine Wörter und keine Zusage für 80 ms Erkennungslatenz.32
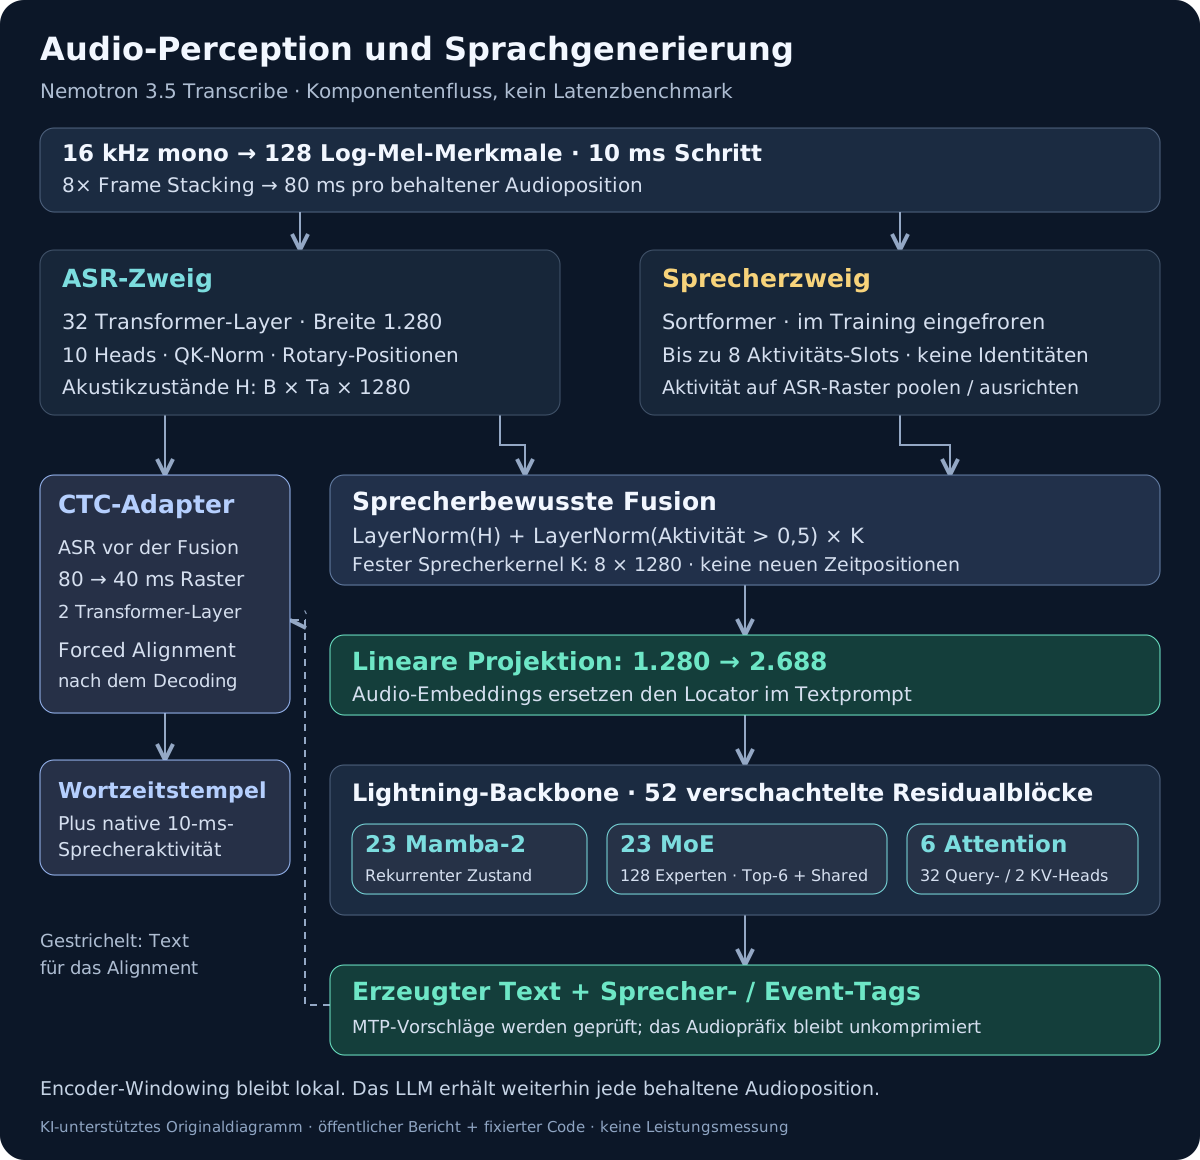
Komponentendiagramm, kein Latenzbenchmark. Das Encoder-Windowing wird unten getrennt erklärt; sämtliche behaltenen Audiopositionen gelangen weiterhin in eine Sprachmodellsequenz.
Sortformer schätzt die Aktivität von bis zu acht Sprecher-Slots. Seine Gewichte bleiben während des Sprachmodelltrainings eingefroren; liegen Referenz-Sprechersegmente vor, kann das Training diese statt vorhergesagter Aktivität verwenden. Die Implementierung poolt/richtet Sprecheraktivität auf dem ASR-Raster aus, binarisiert sie bei 0,5 und wendet eine gelernte LayerNorm über die Sprecherdimension an. Ein fester sinusförmiger Sprecherkernel bildet die acht Slot-Indikatoren anschließend auf die akustische Breite ab. Mit Batchgröße und behaltenen Audioframes werden ASR-Zustände und ausgerichtete Aktivität wie folgt fusioniert; nur bei der Kernelmultiplikation bleiben Batch- und Zeitachsen implizit:
Der gespeicherte Sprecherkernel-Skalierungsfaktor beträgt 1. Seine sinusförmigen Zeilen codieren Sprecher-Slots, nicht Zeit oder bestätigte Identitäten. Die Summe erhält und Breite 1.280; sie hängt nicht acht zusätzliche Eingabetoken pro Frame an. Das LLM erhält so akustischen Inhalt samt Aktivitätszuordnung. Das trennt überlappende Stimmen jedoch nicht in saubere Wellenformen und macht Sprecherzuordnung nicht fehlerfrei.43
Der Identity Connector führt kein weiteres zeitliches Downsampling aus. Eine gelernte lineare Projektion bildet die fusionierte Repräsentation auf die Sprachbreite von Nemotron 3.5 Lightning ab:
NeMo ersetzt den Audio-Locator im User-Turn durch diese Embeddings. Es gibt keinen separaten Cross-Attention-Speicher, der den Textkontext unberührt ließe: Audio und Text werden zu Positionen derselben Decodersequenz. Konzeptionell erzeugt das Modell
Das erklärt Flexibilität und Risiko zugleich. Instruktionen können wortgetreue Sprache, bereinigte Schriftsprache, Terminologie oder eine Zusammenfassung verlangen. Eine flüssige Fortsetzung ist jedoch nicht automatisch akustisch belegt. Zusammenfassung und wortgetreue Annotation sind verschiedene Zielgrößen, auch wenn beide nützlich sind.56
Die Projektion allein bringt einem Text-LLM noch kein Hören bei. Laut Bericht werden ASR-Encoder, Projektion und Sprachmodell ab dem ersten überwachten Fine-Tuning-Schritt gemeinsam trainiert, ohne vorgeschaltete Alignment-Phase mit eingefrorenem LLM. Danach folgt eine kurze Reinforcement-Learning-Phase für Transkriptionsgenauigkeit. Sortformer bleibt eingefroren. Zeitstempeladapter und optionaler externer Drafter werden anschließend auf dem eingefrorenen Zielmodell trainiert. Aufgabenspezifische Instruktions-/Zielpaare lehren, welche Ausgabekonvention aus derselben akustischen Repräsentation entstehen soll.2
Was die 52 Backbone-Blöcke tatsächlich tun
Das veröffentlichte Sprach-Backbone verschachtelt 23 Mamba-2-, 23 MoE- und sechs Attention-Blöcke. Das sind 52 getrennte Residualblöcke, keine 52 konventionellen Layer mit jeweils Attention und FFN. Das Sprach-Backbone hat ungefähr 31,6B Gesamt- und 3,5B aktive Parameter. Perception, Projektion und CTC-Adapter ergänzen ungefähr 0,8B; das gemeinsam genutzte MTP-Modul weitere ungefähr 1,3B Checkpoint-Parameter. Der vollständige Checkpoint enthält ungefähr 34B Parameter, trotz der Kurzbezeichnung 30B-A4B.23
Mamba-2 führt rekurrenten Zustand mit. In einer schematischen Rekurrenz pro Head, ohne die umgebende Faltung, Gates und Normalisierung, aktualisiert eine Eingabe eine Zustandsmatrix, statt sämtliche vergangenen Keys und Values zu speichern:
Konfiguriert sind Zustandswerte pro Head und 64 Heads pro Mamba-Block. Die Rekurrenz verdichtet Historie in einen Zustand fester Größe; sie ist weder eine verlustfreie Aufnahme noch unbegrenztes Transkriptgedächtnis. Attention ermöglicht expliziten Zugriff auf frühere Positionen. Die sechs Blöcke verwenden Grouped-Query Attention mit 32 Query-Heads, zwei KV-Heads und Head-Breite 128: Die Query-Projektion ist , jede Key-/Value-Projektion . Je 16 Query-Heads teilen sich einen KV-Head. Das spart gespeicherte KV-Werte, beseitigt aber nicht die Attention-Berechnung über die wachsende Sequenz.37
MoE steuert FFN-Rechenarbeit pro Position, nicht die Kontextkompression. Jeder MoE-Block hat 128 geroutete Experten, wählt sechs pro Position und führt zusätzlich einen gemeinsamen Experten aus. Für Blockeingabe hat die Routermatrix Form . In der Referenzimplementierung erhalten Sigmoid-Router-Scores für die Auswahl einen Korrekturbias. Die Mischgewichte stammen aus den ursprünglichen Scores, werden über die gewählten sechs normalisiert und mit 2,5 skaliert:
Geroutete Experten sind Zwei-Matrix-FFNs mit und , wobei elementweise quadriert wird. Die Zwischenbreite des gemeinsamen Experten beträgt 3.712. Das gespeicherte moe_latent_size ist null: Bolts LatentMoE-Geometrie ist nicht auf diesen Checkpoint übertragbar. Sechs ausgewählte Experten lassen die übrigen Gewichte nicht aus dem Gerätespeicher verschwinden. Die Gleichungen beschreiben die Referenzberechnung; Produktionskernel können sie anders fusionieren und verteilen.37
Das MTP-Modul enthält einen Attention- und einen MoE-Block, die über zwei Vorhersagetiefen des Trainings gemeinsam genutzt werden. Wiederholte Anwendung kann bei Inferenz mehr als zwei Token vorschlagen; MTP8 sind nicht acht unabhängig trainierte Zusatzlayer. Das Zielmodell verifiziert die Vorschläge. Dies kann Decodierschritte sparen, komprimiert aber weder das Audiopräfix noch vergrößert es den Kontext.2
Wie eine Stunde in 65.536 Positionen passt
Für Dauer in Sekunden erzeugt das Frontend ungefähr Audiopositionen. Ohne Padding-/Rundungseffekte an den Enden liefert ein 30-Sekunden-Chunk 375 Vektoren und eine Stunde 45.000 Vektoren, nicht 3.600 Token. umfasst Instruktionen, Chat-Trenner, Vokabularhinweise und vorherige Konversation; sämtliche erzeugten Token einschließlich Reasoning und Spezial-Tags:
| Aufnahme | Ungefähre Audiopositionen | Verbleibend für sämtlichen Text und Ausgabe |
|---|---|---|
| 15 Minuten | 11.250 | 54.286 |
| 30 Minuten | 22.500 | 43.036 |
| 60 Minuten | 45.000 | 20.536 |
Das ist Budgetrechnung, keine gemessene maximale Transkriptlänge. Stille belegt weiterhin Dauer und Positionen, sofern die Anwendung sie nicht ausdrücklich entfernt. Acht gleichzeitig verfügbare Sprecher-Slots verachtfachen die Audiopositionen nicht; die Transkription mehrerer überlappender Sprecher kann die Ausgabe jedoch erheblich verlängern.28
Eine illustrative, nicht gemessene Stunde mit 150 gesprochenen Wörtern/Minute enthält 9.000 Wörter. Bei angenommenen 1,5 Texttoken/Wort benötigt das Transkript 13.500 Token; mit 512 Prompt-Token ergeben sich insgesamt 59.012 Positionen. Das passt mit 6.524 Positionen Reserve. Schnelle Sprache, andere Tokenisierung/Schriftsysteme, Sprecher-/Event-Tags, Glossar, JSON oder ein zweites übersetztes Transkript können den Spielraum verbrauchen. mit dem veröffentlichten Tokenizer und repräsentativer Ausgabe abschätzen; Wörter/Minute allein sind keine Sicherheitsprüfung.
Das direkte ASR-Beispiel der Model Card erlaubt 16.384 Completion-Token. Diese Obergrenze kann ein Transkript abschneiden, obwohl der Gesamtkontext noch Platz hätte. Das Reasoning-Preset fordert 20.480 Completion-Token an: Mit 45.000 Audio- und 512 Prompt-Positionen ergäbe die Reservierung 65.992, also 456 mehr als das Kontextlimit. Completion-/Reasoning-Budget reduzieren, Eingabe kürzen oder Aufgaben trennen; eine Runtime kann eine zu große Reservierung bereits vor der Generierung ablehnen. Reasoning ist nicht kostenlos und für Transkription nicht der empfohlene Standard.1
Die innere Sprachmodellkonfiguration enthält max_position_embeddings: 262144. Das ist kein Beleg dafür, dass Transcribe vier Stunden zuverlässig verarbeitet. Die Trainings-/Release-Grenze des Speech-Modells bleibt eine Stunde bei insgesamt 65.536 Positionen; ein geändertes Serverflag belegt keine Generalisierung darüber hinaus. Mehrere Audioeingaben oder Folgeturns teilen ebenfalls den Kontext einer Anfrage. Konversationshistorie liefert die Anwendung, nicht ein persistentes Gedächtnis im Dienst.31
Lokale Encoder-Fenster, aufnahmeweiter Sprachkontext
Der technische Bericht beschreibt im Training unabhängige 30-Sekunden-Chunks nach der Merkmalsextraktion, ohne Encoder-Attention über deren Grenzen hinweg. Ihre Ausgaben werden vor dem LLM chronologisch zusammengefügt. Ein anfangs genannter Name kann dadurch über das LLM die Textgenerierung zu einer späteren Passage beeinflussen, obwohl der akustische Encoder nicht über die gesamte Stunde attendiert. In diesem beschriebenen Aufbau sind Sprecher-Slot-Indizes lokal pro Chunk. Konsistente Sprecherlabels über die Aufnahme aufrechtzuerhalten ist Aufgabe des LLM, kein garantiertes biometrisches Matching.2
Chunking begrenzt außerdem die Encoder-Attention-Arbeit. Für Audiopositionen in Chunks mit Positionen skaliert die Anzahl der Attention-Paare ungefähr wie statt . Bei und sind das 120-mal weniger Paare nur für diesen Encoder-Attention-Term, keine 120-fache Modellbeschleunigung. Attention in Fenstern fester Größe ist linear in der Gesamtdauer. FlashAttention vermeidet bereits die materialisierte quadratische Score-Matrix. Hier geht es um weniger Attention-Rechenarbeit und das Kurzkontexttraining des Diarisierers, nicht um die Behauptung, FlashAttention brauche quadratisch gespeicherte Aktivierungen.2
Der Serving-Pfad ist mit diesem Trainingsdiagramm nicht identisch. Das fixierte NeMo-vLLM-Plugin umgeht generisches Wellenform-Chunking, wenn der Parallel Expert Encoder eingebunden ist. Dessen eigener Online-Pfad nutzt kontexterweiterte ASR-Fenster, verwirft Overlap-Ausgaben, verbindet Kernausgaben und führt Sortformers Sprecher-Cache zwischen Fenstern weiter. Ohne Overrides gelten in diesem Quellenstand 500 codierte Kernframes und 50 Kontextframes je Seite: bei 80 ms/Frame ungefähr 40 Sekunden plus je vier Sekunden Links-/Rechtskontext. Das sind Implementierungsdefaults, kein anderes beworbenes Aufnahmelimit. Der gespeicherte Wert encoder_chunk_size_seconds: 30 allein beschreibt nicht zwingend den ausgeführten vLLM-Pfad.94
Keines dieser Fenster setzt den LLM-Kontext zurück, entfernt die 45.000 behaltenen Audiopositionen oder macht das Modell zu kausaler Mikrofon-ASR. Windowing ist auch nicht folgenlos: Grenzakustik, Sprecherkonsistenz und Zusammenführung brauchen weiterhin eine Evaluation nach Dauer und Sprechersituation.
Zum Lang-Audio-Speicherbudget gehört mehr als KV-Cache
Mit Attention-Blöcken, KV-Heads, , Sequenzlänge und Byte je gespeichertem Wert beträgt die KV-Nutzlast des Ziel-Backbones:
Bei BF16 () benötigen allein 45.000 Audiopositionen ungefähr 264 MiB KV-Nutzlast pro Sequenz; bei vollen 65.536 Positionen sind es 384 MiB. Die 23 Mamba-Blöcke benötigen zusätzlich rekurrente Zustandswerte, also 46 MiB bei FP32 pro Sequenz. Dieser zweite Term wächst in der einfachen rekurrenten Zustandsbetrachtung nicht mit der Audiodauer.37
Das sind Komponenten-Nutzlasten, keine VRAM-Spitzenwerte. Nicht enthalten sind Modellgewichte, Mamba-Faltungs-/Replay-Puffer, MTP-/DFlash-Zustand, Audiomerkmale, behaltene CTC-Zustände, Aktivierungen, Allocator-Padding und Workspaces. ReplaySSM verändert Zustandsspeicherung und Neuberechnung; Cache-Datentyp und Runner verändern die tatsächliche Allokation. Gleichzeitige Anfragen vervielfachen anfragespezifischen Zustand; die sechs Attention-Blöcke haben weiterhin wachsende Prefill-/Decodierkosten. Der KV-Cache-Guide trennt Gewichte, Cache und Runtime-Reserve.10
Der Bericht nennt Checkpoint-Größen von ungefähr 67,5 GB BF16, 35 GB FP8 und 21 GB NVFP4, nicht diese Zahlen als Deployment-VRAM-Zusage. NVFP4 ist gemischte Präzision: Es betrifft LLM-Attention-/Expertenprojektionen; Mamba-Projektionen, MTP-Modul und ASR-Projektionen nutzen FP8, mehrere andere Komponenten bleiben höherpräzise. Quantisierung macht weder jede Operation noch jeden Zustand vierbittig. Ihre Auswirkung auf Genauigkeit ist für tatsächliche Sprache, Akustik und Sprecheraufgabe zu prüfen.2
Was der Stundenkontext ermöglicht – und wann Aufteilen sinnvoll bleibt
Aufnahmeweiter Sprachkontext kann das Zusammenfügen unabhängig erzeugter Transkripte reduzieren, Terminologie über ein Interview erhalten und Fragen über weit auseinanderliegende Passagen ermöglichen. Direkte Audiofragen können außerdem akustische Evidenz nutzen, die in einem reinen Texttranskript fehlt. Dies sind Architekturpotenziale, keine Garantie, dass jede entfernte Abhängigkeit, Auslassung oder jeder Sprecherwechsel korrekt verarbeitet wird.
| Verarbeitung | Möglicher Nutzen | Zu behandelnde Grenze |
|---|---|---|
| Vollständige Aufnahme | Ein Sprachkontext für Terminologie, Sprecher und aufnahmeweite Fragen | Größeres Prefill-/Ausgabebudget; Abbruch oder Wiederholung betrifft den ganzen Job |
| Segmente auf Anwendungsebene | Kleinere Jobs, fortsetzbare Verarbeitung und lokale Paar-Audits | Kontextverlust; Overlap-Deduplizierung, Sprecher-Neuzuordnung und absolute Offsets erforderlich |
| Getrennte Transkript- und gezielte QA-Anfragen | Wortgetreue Annotation von Interpretation trennen; Ausgaben einzeln budgetieren | Erneuter Audiolauf, sofern die Runtime Wiederverwendung nicht ausdrücklich unterstützt; kein automatisches gemeinsames Gedächtnis |
| Dedizierte Streaming-ASR | Live-Teilergebnisse und begrenzte interaktive Latenz | Anderes Modell/API; nicht durch Streamen von Transcribes Ausgabetext erreichbar |
Bei Datensätzen Session- und Segment-Offsets auch beim getrennten Prüfen von Clips erhalten. Ein aufnahmeweiter Durchlauf kann fehlende Turns oder inkonsistente Sprecher-Tags auffällig machen; begrenzte Clip-Durchläufe lokalisieren Korrekturen und erlauben Wiederholungen. Grenzwörter und Sprecherlabels ausdrücklich abgleichen und den Trade-off am Korpus messen. Für Deployment-Validierung nach Dauer schichten und frühe, mittlere und späte Spannen getrennt bewerten: einschließlich Auslassungen, Wiederholungen, Sprecherfehlern, Abbruchstatus, First-Token-/Gesamtlatenz und Spitzenverbrauch. Eine einstündige Datei annehmen zu können ist eine Kapazitätsaussage, kein Beleg für gleichmäßige Genauigkeit über deren Verlauf.
Anwendungen jenseits einfacher Transkription
| Workflow | Nützliche Ausgabe | Was getrennt bleiben muss |
|---|---|---|
| Meeting- und Interviewarchive | Sprecherbezogene Mitschriften, durchsuchbare Passagen, vorgeschlagene Entscheidungen/Aufgaben | Eine Zusammenfassung ist kein wörtliches Zitat; Entscheidungen und Zuständigkeiten prüfen |
| Nachgelagerte Contact-Center-Prüfung | Wer was sagte, Terminologiefehler, Fragen zu aufgezeichneten Gesprächen | Offline-Prüfung ist nicht der Live-ASR-Pfad; Sprecherlabels beweisen weder Identität noch Absicht |
| Medienlokalisierung | Originaltranskript, englische Übersetzung, ausgerichtete Untertitelkandidaten | Übersetzungsqualität, Segmentierung und Lesegeschwindigkeit separat prüfen |
| Fachspezifisches Diktat | Terminologie-Prompts und explizite Zahlen-/Einheitenkonventionen | Eine Begriffsliste darf keine im Audio fehlenden Wörter einfügen |
| Regressionstests für Sprachagenten | Archivierte Äußerungen mit erwarteten Inhalten und wichtigen Entitäten vergleichen | Latenz des tatsächlichen Streaming-Erkenners separat testen |
| ASR-Trainingsdatenpflege | Unabhängige Hypothesen, Abweichungsflags und Review-Prioritäten | Weder Modellübereinstimmung noch eine sichere Erklärung ist Ground Truth |
Prompting vor Fine-Tuning ist eine nützliche Baseline. NVIDIAs medizinische Anpassungsstudie berichtet auf zurückgehaltenen Sprechern 22,44 % WER mit dem besten Basismodell-Prompt und 12,17 % nach Anpassung: eine relative Reduktion um 45,8 %. Sie nutzte 855 Tuning-Clips, 2.764 zurückgehaltene Clips, eine feste Scoring-Pipeline und fachspezifische Trainingsdaten. LibriSpeech-test-clean-WER stieg von 1,54 % auf 1,69 %. Das sind berichtete Ergebnisse dieses Rezepts, keine Zusage für eine deutsche Domäne und keine Messungen dieses Blogs.11
Vorhandene Audio-Transkript-Paare prüfen
Für jedes Paar sind vier unabhängige Dimensionen zu trennen: Nutzbarkeit der Aufnahme, Worttreue zum Gesprochenen, Annotationsstil und Sprecher-/Timing-Korrektheit. Sauberes Audio kann falsch beschriftet sein; verrauschtes Audio kann ein hervorragendes Label haben. Eine korrekt annotierte Dialektaufnahme kann gerade deshalb wertvoll sein, weil ein allgemeines Modell damit Schwierigkeiten hat.
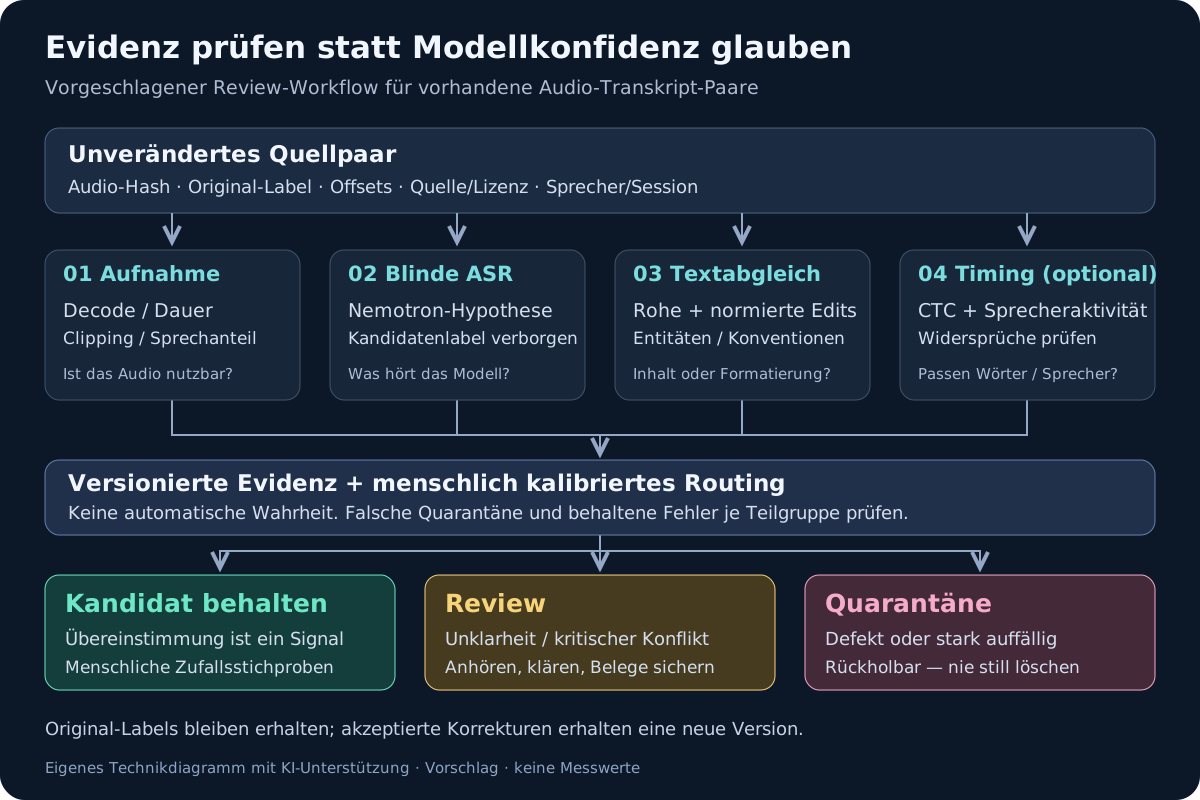
Vorgeschlagener Workflow, kein NVIDIA-Benchmark. Das Diagramm enthält keine gemessenen Qualitätsscores.
1. Original erhalten und untersuchen
Audio-Hash, Originaltranskript, Quelle/Lizenz, Sprecher-/Session-IDs und Segment-Offsets bleiben unverändert. Decodierbarkeit, Abtastrate, Kanäle, Dauer und Sample-Clipping prüfen. Bei Bedarf VAD/Sprechanteil oder einen separat validierten Schallqualitäts-Schätzer ergänzen. Diese Prüfungen bewerten die Aufnahme; sie entscheiden nicht, ob der Text dazu passt. Schwierige, verrauschte und überlappende Beispiele gesondert kategorisieren statt mit beschädigten Dateien gleichzusetzen.
2. Eine blinde Hypothese erzeugen
Transcribe auf dem Audio ausführen, ohne das zu prüfende Transkript zu zeigen. Wenn bekannt, Sprache und Labelkonvention angeben: wortgetreu oder bereinigt, Ziffern oder gesprochene Zahlwörter, Erhalt von Code-Switching und Sprecher-Tags. Prompt, Checkpoint, Quantisierung, Decoder-Einstellungen und Ausgabestatus im Audit-Datensatz speichern. Abgeschnittene Ausgabe, Decode-Fehler und nicht unterstützte Aufgaben bedeuten abstain, nicht schlechte Labels.
Für einen deutschen Korpus mit wortgetreuen Labels ist folgender Startprompt auf einem Entwicklungsset zu prüfen: „Transkribiere diese deutsche Aufnahme wortgetreu. Erhalte Füllwörter, Wiederholungen und Sprachwechsel. Fasse nicht zusammen und ergänze keine fehlenden Informationen. Schreibe Zahlen als gesprochene Wörter.“ Erwartet der Datensatz geschriebene Zahlen oder bereinigten Text, gilt eine andere explizite Konvention. Nicht für jeden Kandidaten einen anderen Prompt wählen, nur um Übereinstimmung zu erzeugen.
Ein zweiter, architektonisch anderer Erkenner wie Parakeet kann für ausgewählte Fälle eine weitere Hypothese liefern. Unterschiedliche Modelle können trotzdem Trainingsdaten und systematische Fehler teilen. Zwei übereinstimmende Systeme sind keine zwei unabhängigen menschlichen Zeugen.
3. Abweichung unter einer definierten Konvention berechnen
sei die blinde Hypothese und eine feste Normalisierungs-/Tokenisierungsregel. Kandidat und Hypothese werden über Edit-Distanz verglichen:
Ist vertrauenswürdige menschliche Ground Truth, ist das gewöhnliche WER von . Wird selbst geprüft, ist es referenznormalisierte Abweichung, keine Schätzung der wahren Labelfehlerrate. Wegen Einfügungen kann der Wert größer als 1 werden; bei leerer Referenz ist eine eigene Entscheidung zu Stille/fehlendem Label nötig. NeMo Curator stellt GetPairwiseWerStage bereit, doch dessen Beispielschwellen sind keine kalibrierten Labelqualitäts-Schwellen für dieses Verfahren.12
Rohe und konventionsnormalisierte Vergleiche mit versioniertem Normalizer speichern. Negationen, Einheiten, Dezimalwerte und bedeutungstragende Namen dürfen nicht verschwinden. CER oder sprachgeeignete Segmentierung nutzen, wenn Whitespace-Worttokenisierung ungeeignet ist. Kritische Entitäten separat vergleichen: Eine falsche Dosis kann wichtiger sein als mehrere Füllwortunterschiede.
Die folgenden Beispiele sind illustrativ, keine Modellausgaben:
| Kandidatenlabel gegenüber Gehörtem | Wahrscheinliche Audit-Kategorie | Aktion |
|---|---|---|
25 Euro gegenüber fünfundzwanzig Euro | Schrift-/Sprechform-Konvention | Für den Vergleich normalisieren; beabsichtigtes Trainingsziel erhalten |
50 mg gegenüber 15 mg | Kritische lexikalische Abweichung | Audio prüfen; nie stillschweigend die neue Hypothese wählen |
| Wiederholter Satz ohne entsprechende Sprache | Mögliche Halluzination oder falsches Segment | Offsets, Stille und beide ASR-Hypothesen prüfen |
| Richtige Wörter beim falschen Sprecher | Zuordnungsfehler | Sprecheraktivität und Transkript-Tags getrennt prüfen |
4. Alignment und Audiofragen als zusätzliche Evidenz nutzen
Timing ist eine getrennte Berechnung, nicht eine Anforderung, Tausende Zeitstempel-Token im Transkript auszugeben. Der ungefähr 50M Parameter große CTC-Adapter erhält die nicht fusionierten ASR-Zweigzustände mit Breite 1.280. Eine transponierte Faltung mit Stride zwei skaliert deren 80-ms-Raster auf 40 ms hoch; darauf folgen zwei Transformer-Layer mit 16 Heads und eine Projektion auf ein eigenes Vokabular von 23.862 Token plus CTC-Blank. Nach dem Decoding richtet Forced Alignment die vorgegebene erzeugte Wortsequenz an diesen Frame-Wahrscheinlichkeiten aus; native Sortformer-Aktivität verfeinert die Grenzen zusätzlich. Upsampling lernt ein feineres Vorhersageraster, keine höher abgetastete Eingabeaufnahme. Weder das 40-ms-Modellraster noch das 10-ms-Verfeinerungsraster ist eine gemessene Fehlerschranke für Zeitstempel.23
Der CTC-Head richtet eine vorgegebene/erzeugte Wortsequenz an akustischen Zuständen aus. NeMo verwendet nach der Generierung abgetrennte ASR-Zustände weiter und muss den Audioencoder für Zeitstempel daher nicht erneut ausführen. Die Implementierung trennt außerdem CTC-Wortgrenzen von nativen Sortformer-Sprecheraktivitätssegmenten auf einem 10-ms-Raster. Letztere und nicht die Lücken zwischen ausgerichteten Wörtern sind das passende Timing-Produkt für Diarisierungsevaluation.6
Erfolgreiches Forced Alignment zertifiziert kein Transkript: Ein dynamisches Programm kann falsche Wörter auf plausible Frames zwingen. Umgekehrt kann eine Modellgrenze das Alignment eines korrekten Transkripts erschweren. Alignment-Fehler und auffällige Abdeckung sind Review-Signale, keine Beweise für falsche Labels. Die gewöhnliche API liefert dadurch auch keine kalibrierte Wahrscheinlichkeit, dass ein beliebiges Paar korrekt ist.
Audio-Q&A kann Reviewern helfen zu fragen, ob Sprache fehlt oder eine Entität geprüft werden sollte. Sieht ein zweiter Durchlauf den Kandidaten, soll er diesen ausdrücklich als nicht vertrauenswürdige Daten behandeln, unbelegte/fehlende Spannen unterscheiden und bei Unsicherheit verzichten. Seine Befunde bleiben von der blinden Hypothese getrennt. Selbst genannte Konfidenz ist nicht kalibriert; auf Englisch trainiertes Audio-Q&A ist kein automatisch validierter Richter für deutsche Korpora.
5. Routing kalibrieren statt magischen Qualitätsscore erfinden
Mit retain_candidate, review und quarantine beginnen und Begründungscodes wie format_only, entity_conflict, missing_speech, speaker_mismatch, decode_failure und uncertain erhalten. Quarantäne ist rückholbar und keine Löschung. Auch behaltene Kandidaten brauchen zufällige menschliche Stichproben.
Ein Audit-Manifest sollte original_text, blind_hypothesis, normalizer_revision, raw_disagreement, normalized_disagreement, audio_flags, pair_flags, alignment_status, decision, reviewer und die Modell-/Runtime-Revision getrennt speichern. Nicht berechnete Felder bleiben null. Eine strukturierte Modellantwort ist zu prüfende und zu speichernde Evidenz, keine Erlaubnis, das Quell-Label zu überschreiben.
Ein unabhängig menschlich geprüftes Kalibrierungsset nach Sprache, Akzent, Quelle, Dauer, Rauschen, Überlappung und Transkriptstil schichten. Nach Sprecher/Session aufteilen, um Leakage zu reduzieren. Schwellen anhand der gewünschten Präzision automatischer Quarantäne wählen und sowohl fälschlich aussortierte korrekte Paare als auch behaltene Annotationsfehler messen. Nach Modell- oder Normalizer-Wechsel jede Teilgruppe erneut prüfen. Ein auf geringe Modellabweichung optimierter Teacher kann sonst schwierige, aber korrekte Akzente entfernen und den nächsten Trainingssatz weniger repräsentativ machen.
Den Audit nicht mit dem finalen Benchmark vermischen, Referenzen nicht durch Modellvorhersagen überschreiben und Fine-Tunes nicht auf Teacher-umgeschriebenen Labels evaluieren, als wären diese unabhängige Wahrheit. Eine akzeptierte Korrektur wird als neues, versioniertes Label mit Evidenz und Review-Provenienz gespeichert.
Granary v2: Verträge wiederverwenden, keine Ein-Modell-Pipeline erfinden
Granary v2 und NeMo Curator liefern nützliche Bausteine. Die veröffentlichten Tutorials trennen Metadatenextraktion, ASR und Textanreicherung. Das Qwen3-Omni-ASR-Tutorial hält das Original-Label explizit aus dem ASR-Prompt heraus, prüft verdächtige Wiederholungen/Phrasen und erhält die Fallback-Provenienz. Das Texttutorial erzeugt tn_raw, itn_raw und itn_clean für wortgetreue Sprechform, wortgetreue Schriftform und bereinigte Schriftform.131415
Zwei Grenzen werden leicht übersehen: Die Textpipeline liest keine Wellenformen. Ihre QA-/Captioning-Stufen arbeiten auf Transkripten und können keine akustische Treue bestätigen. Außerdem verwenden diese eingecheckten Rezepte mehrere Modelle, nicht Transcribe als bereits validierten Drop-in-Qualitätsscorer. Das Metadatentutorial dokumentiert zudem private Referenzcheckpoints für exakte Reproduktion. Datenverträge und verfügbare Stufen wiederverwenden, aber keine Ein-Kommando-Parität mit NVIDIAs gesamter Trainingspipeline versprechen.
Serving-Entscheidungen verändern den Audit
Das Launch-Rezept nutzt vLLM 0.32.0 plus NeMo-Speech-Plugin. Audiolimits müssen für einstündige Dateien erhöht werden; das gemeinsame Prompt-/Ausgabebudget muss passen. Benötigte Sprecher-Tags erhalten, Abschlussstatus prüfen und angefordertes JSON gegen das eigene Schema validieren. Ein OpenAI-kompatibler Endpunkt bedeutet nicht, dass alle Speech-Endpunkte, Parameter oder Zeitstempelerweiterungen austauschbar sind.101
Die Decoder-Standardlimits betragen 600 Sekunden und 25 MB. Das Launch-Beispiel erhöht sie mit VLLM_MAX_AUDIO_DECODE_DURATION_S=3600 und VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180. Eine Stunde 16-kHz-Mono-PCM16 benötigt vor Headern ungefähr 115,2 MB; allein die decodierte Float32-Wellenform ungefähr 230,4 MB Hauptspeicher. Eine Float32-WAV überschreitet die Beispieldateigrenze trotz passender Dauer. Komprimierte Uploadgröße, decodiertes Audio, Base64-/Request-Overhead und Reverse-Proxy-Limits getrennt prüfen.101
Die fixierte Serving-Dokumentation beschreibt, dass die Encoder-Fenster einer langen Aufnahme in dem Engine-Schritt laufen, der sie aufnimmt; bereits decodierende Anfragen warten dabei. Chunked LLM Prefill ist nicht automatisch unterbrechbares Audioencoding. Lange Offline-Jobs von latenzkritischem Verkehr trennen und Zulassungslimits sowie Batching unter Last prüfen, statt max_num_seqs als Zusage für entsprechend viele einstündige Anfragen zu interpretieren.10
MTP und der separate DFlash2-Drafter sind alternative Beschleunigungspfade. Die Launch-Model-Card empfiehlt DFlash2 zunächst mit sieben spekulativen Token; fünfzehn waren auf ihrem getesteten ASR-Workload langsamer. Bei diesem Quellenstand deaktiviert DFlash2 CTC-Wortzeitstempel. Die neuere generische NeMo-Runtime-Dokumentation beschreibt breitere, vom Runner abhängige Zeitstempelunterstützung. Daher die konkrete Kombination aus Checkpoint, Plugin und Runner prüfen, statt Launch-Kommandos mit späteren Defaults zu vermischen.16
Für einen Audit-Benchmark GPU, tatsächliche Checkpoint-Präzision, Audiodauern, Batch/Concurrency, Prompt, Ausgabelänge und einbezogenes Alignment protokollieren. Der aggregierte Echtzeitfaktor misst Durchsatz, nicht die Latenz eines einzelnen Aufrufs. „100 Stunden in wenigen Minuten“ ist ohne diese Bedingungen nicht übertragbar. Ebenso gibt lokale Ausführung Kontrolle über den Verarbeitungsort, garantiert aber allein weder Datenschutz noch Schwärzung oder Einwilligung.
Insbesondere verwenden die Serving-Kurven des technischen Berichts 30-Sekunden- und Zehn-Minuten-Aufnahmen auf einer RTX PRO 6000 Blackwell Server Edition mit 96 GB, einen optimierten NIM-Stack, Warm-up, begrenzte Parallelität und keine angeforderten Zeitstempel. NVIDIA grenzt diese Optimierungen ausdrücklich von der Open-Source-Integration am Releasetag ab. Das sind keine Stunden-Latenzmessungen. Weder die Geschwindigkeit kürzerer Eingaben noch der private optimierte Stack sind auf das fixierte öffentliche Rezept zu extrapolieren.2
Das nützliche Ergebnis ist eine nachvollziehbare Review-Queue: Welche Paare sind auffällig, warum, welche Evidenz wurde geprüft und wie viele korrekte Beispiele entfernt die Regel versehentlich? Nemotron 3.5 Transcribe kann dafür reichhaltige Evidenz liefern. Es sollte nicht die unangefochtene Ground Truth dieses Systems sein.
Primärquellen
Footnotes
-
NVIDIA, Nemotron 3.5 Transcribe Model Card, Snapshot
c421d6a, 28. Oktober 2026: Aufgabenmatrix, Architektur, Präzision, Kontext, Inferenz und Launch-Grenzen. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 -
NVIDIA, Nemotron 3.5 Transcribe Technical Report, 28. Oktober 2026; §§2.1–2.7 zu Architektur, lokalen Sprecherindizes, Chunking, MTP, Zeitstempeln und Quantisierung; §4.13 zu NIM-Messbedingungen. Geprüfte PDF-SHA-256:
8ff2bad60f5deb87966e90602c19c3b1681acf1ebd4b19ab866bf3e44792fda7. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 -
NVIDIA, exportierte Speech-Konfiguration und Sprach-Backbone-Konfiguration, gleiche Revision; Frontend, Sprechervertrag, Blockzahlen, Expertenformen und Cache-Dimensionen. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8
-
NeMo Speech, Parallel-Expert-Encoder-Implementierung,
_speaker_features,_fuse_diar_and_asrund_forward_online_impl: binarisierte Sprecherfusion, Kontextfenster und Zustand des Streaming-Diarisierers. ↩ ↩2 -
NeMo Speech, Perception-Implementierung, Connector/Projektion und Encoder-Datenfluss. ↩
-
NeMo Speech, SpeechLM-Modelle und CTC-Zeitstempelvertrag, getrennte Wort-/Diarisierungszeitachsen und Opt-in-Verhalten. ↩ ↩2 ↩3
-
Hugging Face Transformers v5.5.0, NemotronH-Referenzimplementierung, Mamba-Zustandsformen, Attention-Projektionen, Experten mit quadrierter ReLU und Top-k-Routing über korrigierte Scores. ↩ ↩2 ↩3
-
NeMo Speech, exportabhängige Audiotoken-Arithmetik,
_estimate_audio_tokens_single_passund Prompt-Platzhalterexpansion; Padding/Stacking beeinflussen die exakte Endrundung. ↩ -
NeMo Speech, vLLM-Audio-Forward und Audiopositions-Schätzer, PEE-spezifische Umgehung generischen Chunkings und vollständige behaltene Embedding-Sequenz. ↩
-
NeMo Speech, fixierte vLLM-Serving-Dokumentation, Environment-Kompatibilität, Audiolimits, Mamba-Zustandspräzision und Encoder-Graphs. ↩ ↩2 ↩3 ↩4
-
NeMo Speech, medizinische Anpassungsstudie, Evaluation auf zurückgehaltenen Sprechern, Konventionssteuerung und Retention-Trade-offs. ↩
-
NeMo Curator, WER-Stufendokumentation, referenzbasierte Metrik und Stufen-API; Beispielschwellen validieren die vorgeschlagene Audit-Regel nicht. ↩
-
NeMo Curator, Granary-v2-Tutorialindex, getrennte Metadaten-, ASR- und Textstufen. ↩
-
NeMo Curator, Qwen-Omni-ASR-Tutorial, blinde Transkription, heuristische Checks und erhaltene Fallback-Provenienz. ↩
-
NeMo Curator, Textpipeline-Tutorial, textbasierter Umfang, Zielvarianten und Audit-Notizen. ↩