
Das nützliche Ergebnis dieser Optimierungskampagne besteht aus konkreten Änderungen am Datenfluss der Inferenz. Qwen3.8-Flash-Next stieg von 131,6 / 702,4 / 1.168,2 aggregierten Ausgabetokens/s in der ersten funktionierenden AMD-Konfiguration auf 282,0 / 1.199,2 / 2.256,6 in Konfiguration k38, bei 1, 8 und 32 parallelen Streams. Das entspricht +114,4 %, +70,7 % und +93,2 % auf demselben AMD-Deployment-Pfad. Die Arbeit verringerte wiederholte Writes des rekurrenten Zustands, verwendete Attention-Keys über mehrere Verifikationszeilen hinweg wieder, fusionierte Routing und Quantisierung und änderte die Präzision empfindlicher Residualprojektionen.12
Das sind eigene Beobachtungen aus meiner Serving-Kampagne und keine unabhängige Hardware-Rangliste. Die zugehörigen CSVs enthalten 118 Beobachtungen je Nebenläufigkeitsstufe über 40 Konfigurationslabels vom 8.–10. Oktober 2026. Der öffentliche Plugin-Code macht die Mechanismen prüfbar. Dieser Beitrag rechnet Vergleiche nach, bewahrt ungültige Läufe und Rückschritte und unterscheidet Code, Messwerte und Erklärungen. Die GPU-Experimente werden dafür nicht erneut ausgeführt.
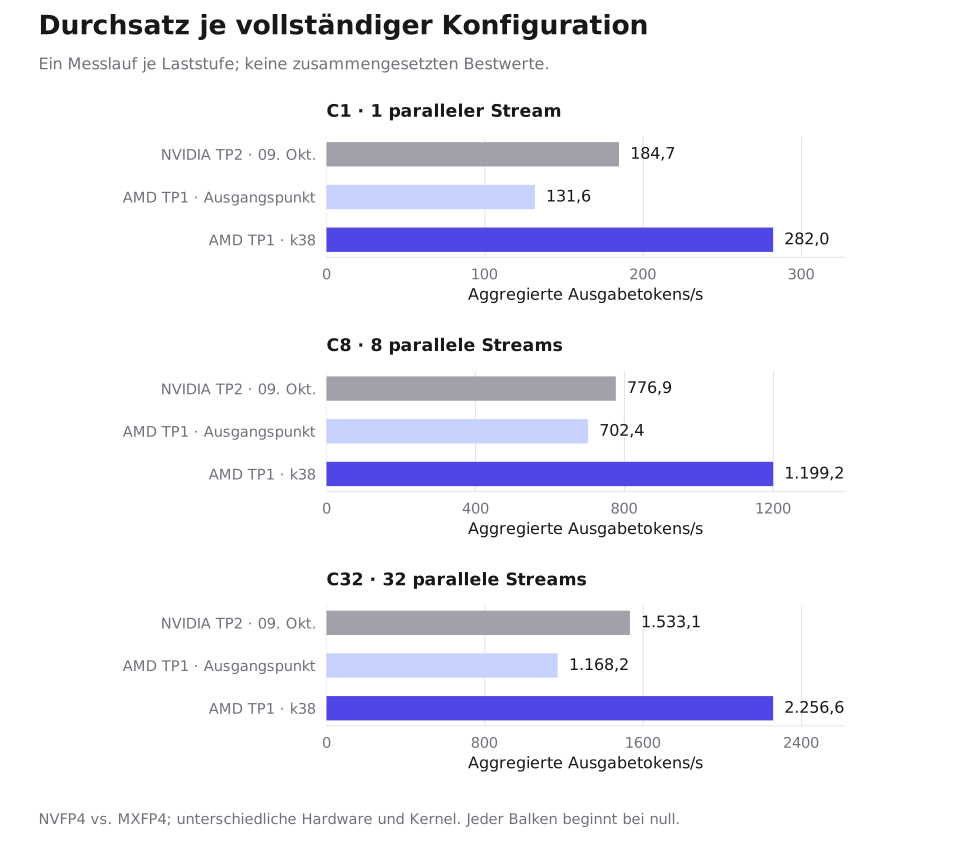
Die Hauptgrafik verwendet einen vollständigen NVIDIA-Kontrolllauf und eine vollständige AMD-Konfiguration. Hardware, Parallelisierung und Quantisierung unterscheiden sich. Jedes Diagramm besitzt eine eigene Skala mit Nullpunkt. Die Werte lassen sich in der Vektorgrafik genauer betrachten.
Was tatsächlich verglichen wurde
Das AMD-Deployment verwendete eine MI350P, 144 GB HBM3e, 128 Compute Units, TP1 und einen eigenen MXFP4-Checkpoint. Das NVIDIA-Deployment verwendete zwei RTX PRO 6000 Blackwell Server Edition mit jeweils 96 GB GDDR7, TP2 und NVFP4. Beide Seiten hatten eigene Kerneloptimierungen; die NVIDIA-Referenz war ein Produktionsdeployment und kein unoptimierter Kontrollaufbau.34
Die Kampagnennotizen beschreiben NVIDIA-Arbeit rund um vLLM 0.30.0 und ein AMD-Image mit vLLM 0.31.1rc1.dev88, ROCm 7.2.3 und AITER 0.1.24.post1. „Dasselbe vLLM“ wäre daher zu weitgehend: Es sind unterschiedliche Backend-Builds und Präzisionsrezepte. Die geprüfte Plugin-Revision ist 8d09f300f4dc1542081c39abe7521f1e29508f5a. Die CSV dokumentiert Endpunkt-Aliase, keine Gewichts-Hashes, Image-Digests oder vollständigen Startmanifeste.
Der angegebene AMD-Checkpoint belegte etwa 115 GiB. Das überschreitet die Kapazität einer einzelnen 96-GB-Karte. Eine einzelne GPU mit mehr Speicher kann die Collectives eines tensorparallel arbeitenden Zwei-Karten-Deployments vermeiden; dieser Vergleich isoliert den Effekt aber nicht. Er belegt auch weder Energieeffizienz noch Gesamtkosten: Synchronisierte Strom- und Kostendaten fehlen im Messprotokoll. Der Guide zur Inferenzmathematik erklärt die getrennten Rollen von Rechenarbeit, Speicherverkehr und Kommunikation.
Den Benchmark prüfen, bevor man den Speedup interpretiert
Das archivierte abbench.py erzeugt Streams in einer geschlossenen Schleife: Jeder startet seine nächste Anfrage erst nach Abschluss der vorherigen. Es fordert 384 Ausgabetokens an, verwendet Temperatur 0,2, setzt ignore_eos=True und zählt zurückgegebene Token-IDs statt Streaming-Events. Der Bericht beschreibt Essay-Prompts und nominelle 60-Sekunden-Fenster; im Protokoll stehen zusätzlich längere Fenster und mit Profiler gekennzeichnete Läufe.51
Aggregierter Durchsatz ist die Zahl erfolgreicher Ausgabetokens geteilt durch die gemessene Gesamtzeit. Nach Ablauf des Fensters starten Worker keine neuen Anfragen, schließen ihre laufende Anfrage jedoch ab. Diese Restzeit zählt mit. Die mediane Decode-Rate pro Anfrage schließt dagegen die Startzeit aus und hat einen anderen Nenner. Median mal Nebenläufigkeit rekonstruiert deshalb nicht den aggregierten Durchsatz. Der Prompt-Generator verwendet zeitabhängige Seeds: Verschiedene Varianten teilen ein Erzeugungsrezept, aber keinen identisch wiederholten Prompt-Korpus.
Laut Bericht gab es pro Laststufe 20 Sekunden Aufwärmzeit. Das archivierte Skript sendet selbst nur eine Aufwärmanfrage mit 32 Tokens; die CSV enthält keine Aufwärmmetadaten. Zusätzliche manuelle Aufwärmung ist möglich, aber aus diesen Artefakten nicht belegbar. Für die berichteten Temperaturtaktraten, Langzeitverschlechterungen und Tests nach dem Produktionswechsel fehlen hier ebenfalls Telemetrie oder passende Zeilen. Sie bleiben Kampagnennotizen und werden nicht als aus der CSV rekonstruierte Messungen dargestellt.
| Beleg | Behandlung in diesem Artikel |
|---|---|
k6, keine Anfragefehler, aber berichtete Ausgabekorruption | Aus gültigen Leistungsvergleichen ausgeschlossen; im Verlauf sichtbar |
k8, Korruptionsnotiz und 32 Anfragefehler bei C32 | Gesamte Konfiguration ausgeschlossen; die C32-Null ist ein fehlgeschlagener Lauf |
k34b C32, ein Anfragefehler | Als fehlerbehaftete Beobachtung markiert |
k10 C1/C8, Nullwerte in der Übersicht | Fehlende Beobachtungen statt Nulldurchsatz; keine passenden Protokollzeilen |
k29 / k32, Profiler-Kennzeichnung | Bewahrt; keine kontrollierten Ablationen einer einzelnen Änderung |
| 118 Zeilen, insgesamt 33 Anfragefehler | Erfolgreicher Transport bleibt von numerischer Korrektheit getrennt |
Die ursprüngliche Ergebnisdarstellung verwendete den besten NVIDIA-Durchsatz je Laststufe: 184,7 / 776,9 / 1.627,7, zusammengesetzt aus zwei unterschiedlichen Messreihen. Der vollständige Kontrolllauf vom 9. Oktober lautet dagegen 184,7 / 776,9 / 1.533,1. Gegen diesen vollständigen Lauf liegt k38 52,7 %, 54,4 % und 47,2 % höher. Gegen den größeren beobachteten NVIDIA-C32-Wert beträgt der C32-Vorsprung 38,6 %. Beide Rechnungen beschreiben ihre jeweiligen Nenner korrekt; sie sind aber nicht austauschbar.
Ebenso ist 282,0 / 1.206,2 / 2.405,1 keine einzelne AMD-Konfiguration: C1 stammt aus k38, C8 aus k41 und C32 aus k39. Dieser Artikel verwendet k38 als Hauptergebnis und nennt die anderen Beobachtungen ausdrücklich. Zwei NVIDIA-Messreihen und viele sich ändernde AMD-Varianten sind zu wenige und zu heterogen, um daraus Konfidenzintervalle zu konstruieren oder jede Änderung kausal zuzuordnen.
Die ältere NVIDIA-„Stock“-Zeile des Berichts, 198 / 711 / 854, verwendete einen anderen Benchmark mit Wiederholungskorpus und hat keine passenden Zeilen im gelieferten Oktober-Protokoll. Sie bleibt aus den Grafiken ausgeschlossen. Ihre Kombination mit den drei Zeilen des vergleichbaren Benchmarks wäre kein kontrollierter Vierfachvergleich von Stock-/Optimized-Hardware.
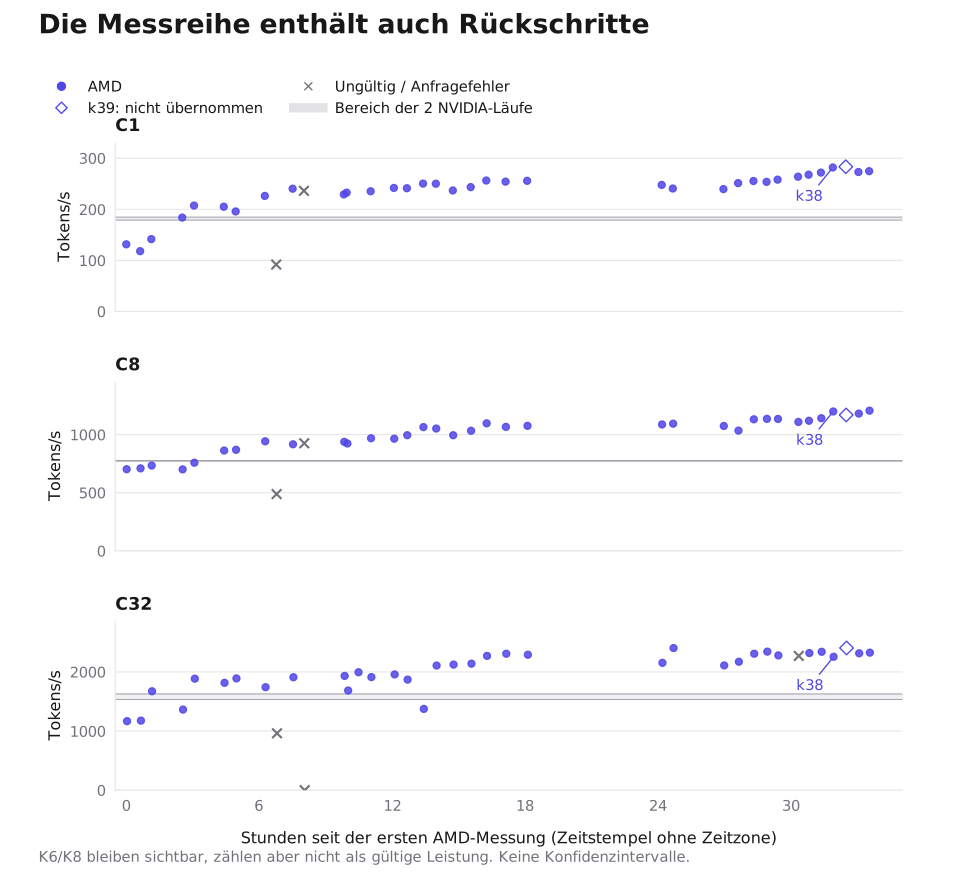
Die Zeitachse beginnt bei der ersten AMD-Beobachtung. CSV-Zeitstempel haben keine Zeitzone. Das graue Band ist der Bereich zweier NVIDIA-Beobachtungen, kein Unsicherheitsintervall. Die Kreuze enthalten Läufe, die nicht als korrekter Durchsatz zählen dürfen. Vollständigen Verlauf öffnen.
Warum dieses Modell unterschiedliche Engpässe sichtbar machte
Die fixierte Upstream-Konfiguration hat 48 Schichten: 36 Gated DeltaNet (GDN) und 12 Qwen Sparse Attention (QSA). Die Residualbreite ist 2.560, mit vier gegateten Residualzweigen und einer Low-Rank-Breite von 320. Jede Schicht besitzt 512 geroutete Experten, zehn davon werden pro Token ausgewählt. Hinzu kommt ein Shared Expert mit Zwischenbreite 640. Spekulatives Drafting mit vier Tokens erzeugt bis zu fünf Verifikationspositionen pro Anfrage im Zielmodell. Bei C32 können daher 160 Zeilen an einem kleinen Decode-Kernel anliegen.6
Die Arbeit ist nicht gleichförmig. GDN aktualisiert wiederholt eine rekurrente FP32-Matrix. QSA bewertet und lädt ausgewählten Kontext. MoE verteilt kleine Tokengruppen auf Experten-GEMMs. Die vier Residualzweige erzeugen abhängige Projektionen und Gates. Eine sinnvolle Optimierung muss zur Tensorform und zum tatsächlich gewählten Backend-Pfad passen; „6B aktiv“ auf Modellebene sagt diese Kosten nicht voraus. Der Architektur-Guide erklärt die N-Gram-Tabelle und den Residualaufbau genauer.
Lektion 1: Eine korrekte Baseline von einer schnellen unterscheiden
Der erste AMD-Punkt enthält bereits einen eigenen quantisierten Checkpoint und Korrektheitspatches. „Stock vLLM“ würde diese Voraussetzungen verdecken. Der öffentliche Patch-Code beschreibt drei unterschiedliche Vorfälle: einen zurückgewiesenen Hostcall-Pfad auf einer Plattform ohne PCIe-Atomics, redundantes MoE-Padding und das Lesen uninitialisierter Daten in einem optimierten FlyDSL-Zwischenlayout.7
Beim Padding gibt es einen konkreten Vertrag zwischen Erzeuger und Verbraucher. Die logische Experten-Zwischenbreite ist 640, das gewählte Layout nutzt 768 Spalten. Schreibt Stufe 1 nur die logischen Spalten und liest Stufe 2 die gepaddete Breite, müssen die unberührten 128 Spalten und ihre Skalierungsbytes gültige Nullen enthalten. Das E8M0-Skalierungsbyte 0xFF steht für NaN. Eine wiederverwendete Allokation kann einen schnellen Pfad daher in stille Datenkorruption verwandeln. Das Plugin verwendet persistent nullinitialisierte Puffer, um diese Invariante ohne zwei Fills pro Aufruf und Schicht zu erhalten. Pufferwiederverwendung verlangt außerdem kompatible Layouts und überlappungsfreie Lebenszeiten; „persistent“ allein macht sie nicht sicher.
Die verlinkte Upstream-Padding-PR betrifft GPT-OSS und dokumentiert verwandte Alignment-Probleme. Sie bestätigt diese Fehlerklasse, nicht unabhängig jedes Qwen-Ergebnis der Kampagne. Der Source-Rewrite schlägt bei einem veränderten erwarteten Anker fehl, statt unbemerkt ein ungeprüftes Backend zu aktivieren. Diese Revisionsprüfung ist relevant, wenn sich die Serving-Engine wöchentlich ändert.8
Lektion 2: Weniger rekurrente Snapshots speichern und das akzeptierte Präfix wiederholen
Für einen Value-Head sei der GDN-Zustand eine Matrix . In der Orientierung der Implementierung adressiert ein normalisierter Key die Spalten; ein Value liefert die Zeilen. Eine vereinfachte Rekurrenz mit Decay und Update-Gate lautet:
Dabei enthält die Normalisierung und Skalierung der Implementierung. Der Code berechnet den Decay aus seinem Softplus-Gate und aktualisiert jede Value-Head-Matrix. Mit 48 Value-Heads und FP32-Speicherung enthält ein Snapshot pro Anfrage und Schicht 3 MiB. Gewöhnliche MTP-4-Verifikation schreibt fünf solcher Snapshots, damit der nächste Schritt den Zustand des akzeptierten Präfixes auswählen kann.9
Deferred Commit speichert den Zustand nach Token 0, das immer akzeptiert wird, sowie kompakte Eingaben der übrigen Tokens. Der nächste Schritt rekonstruiert den akzeptierten Zustand durch Wiederholen nur des akzeptierten Präfixes. Das tauscht wiederholte vollständige Matrix-Writes gegen kompakte Records und zusätzliche Rekurrenzarbeit. Die Prefix-Cache-Ausrichtung gehört zum Vertrag: In der Nähe einer Grenze schreibt die Implementierung gewöhnliche Snapshots, damit andere Cache-Leser den erwarteten Zustand erhalten.
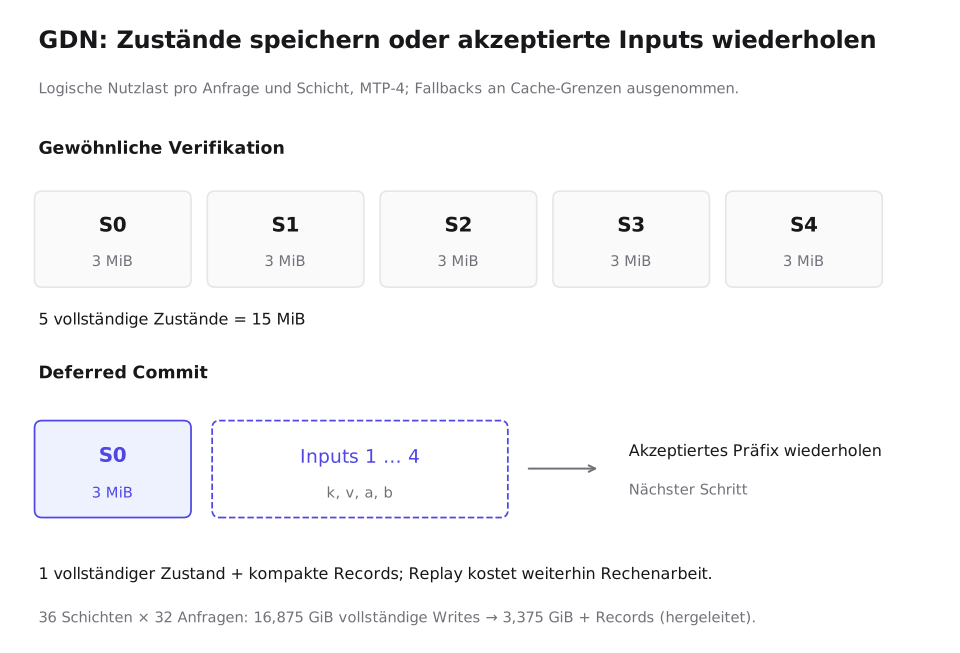
Die Byte-Rechnung muss den ganzen Stack berücksichtigen. Unter der genannten Annahme vollständiger Writes gilt:
Ein vollständiger Write pro Zielmodellschicht und Anfrage wären 3,375 GiB, zuzüglich Records und Grenz-Fallbacks. Dieser logische Vergleich spart bis zu 13,5 GiB vollständiger Zustands-Writes. Die 4,6-GiB-Schätzung des ursprünglichen Berichts folgt nicht aus dessen angegebenen Dimensionen. Diese Zahlen beschreiben logische Nutzlast, keine mit Hardware-Countern gemessenen HBM-Transfers, Gesamtallokation oder gemessene Schrittzeit. Cache-Verhalten und Replay-Rechenarbeit bleiben relevant.
Eine spätere Variante drückt Rekurrenzblöcke mit FP32-Matrix-Core-Operationen aus. Die berichtete C32-Zeit je Schicht änderte sich von 181 auf 127,6 µs: 29,5 % weniger Zeit beziehungsweise 1,42× isolierter Durchsatz. Das sind berichtete Kernelbeobachtungen der Kampagne, kein End-to-End-Speedup von 42 %. Die skalare Replay-Variante prüft bitweise Zustandsäquivalenz. Die Matrix-Core-Variante akkumuliert in anderer Reihenfolge und prüft eine Toleranz gegen eine FP64-Rekurrenz. Der Code trennt diese Verträge ausdrücklich.
Lektion 3: Ein dünnbesetzter Operator kann einen exakten dichten Sonderfall besitzen
QSA wählt über komprimierte Blockindizes ein Budget von 2.048 Kontexttokens aus. Passen alle sichtbaren Tokens hinein, kann die ausgewählte Menge das gesamte kausale Präfix sein. Eine Sparse-Liste zu laden erzeugt dann Indirektion, ohne Daten wegzulassen. Der dichte Pfad durchläuft die Seitentabelle in Tokenreihenfolge und teilt K/V-Tiles unter den Verifikationsqueries einer Anfrage.10
In diesem Checkpoint bedient jeder KV-Head zwölf Query-Heads. Fünf Verifikationspositionen ergeben deshalb 60 Query-Zeilen pro KV-Head, die in das 64-Zeilen-Tile des Kernels passen. Die Optimierung verwendet jedes K/V-Tile für diese Queries wieder, wendet pro Zeile die kausale Maske an und führt partielle Softmax-Statistiken zusammen. Sie ersetzt die Sparse-Selektion langer Kontexte nicht durch beliebige dichte Attention. Die Bedingungen verlangen unter anderem höchstens 2.048 Sequenzpositionen und passende Tile-Kapazität. Draft-Schritte mit wiederverwendeter früherer Sparse-Selektion umgehen den dichten Pfad. Unter vier Anfragen behält der Code ebenfalls den gewöhnlichen Pfad.
Die berichtete QSA-Arbeit bei C32 sank im Kampagnenprofil von etwa 2,85 auf 0,7 ms pro Schritt. Das ist eine Modulmessung bei einem konkreten Muster zulässiger Anfragen. Sie bedeutet weder vierfachen Modelldurchsatz noch einen universellen Vorteil für lange Kontexte. Die Tokenmenge ist unter den Guards äquivalent; Token- und Reduktionsreihenfolge können trotzdem BF16-Rundung verändern.
Lektion 4: Dispatch und Präzision an den tatsächlichen Decode-Formen optimieren
Der Eingang des gerouteten Feed-Forward-Pfads hat die Form [M, 2560]. Routing erzeugt zehn Experten-IDs mit Gewichten und einen Shared-Expert-Slot, also Dispatch-Metadaten der Form [M, 11] über 513 Experteneinträge. Der fusionierte Pfad berechnet Gating und tokenweise MXFP4-Quantisierung gemeinsam. In einem zweiten Launch baut er das nach Experten sortierte Layout aus Bitmaps auf. Er zielt auf kleine , in diesem Preset bis 160, und ersetzt nicht pauschal jeden großen Prefill-Pfad.11
Sein Exaktheitsvertrag umfasst Gleichstände zugunsten kleinerer Indizes, unterschiedliche Experten-IDs auch bei nicht endlichen Aufwärm-Logits, passende Exponentialarithmetik und Padding-Stores. Die berichteten Routing-Zeiten bei sanken von 21,7/30,3/33,0 auf 11,7/14,1/14,5 µs. Weniger Launches helfen nur, wenn Register, Speicherlayout und Occupancy des Ersatzes weiterhin zum Gerät passen. Tactic-Tabellen für einen 256-CU-Beschleuniger passen nicht automatisch zur MI350P mit 128 CUs.
Präzision ist ebenfalls eine lokale Entscheidung. Die Residualprojektionen arbeiten auf der Vier-Zweig-Breite 10.240 über eine Zwischenbreite von 320. Nach großen Logit-Abweichungen verwarf die Kampagne MXFP4 für diese Projektionen und verwendete stattdessen FP8 W8A16. Der Code hält Skalen pro Output-Kanal, erweitert FP8-Gewichte im Kernel auf BF16 und skaliert den Akkumulator. Das ist ein approximativer Gewichtspfad und keine Aussage, dass die gesamte Modellarithmetik bitweise unverändert bleibt.12
Auch die Vokabularprojektion belastet die Bandbreite: [248320, 2560] enthält in BF16 rund 1,27 GB dezimale Gewichte. Ihr MXFP4-Screening berechnet die besten 64 Kandidaten mit den ursprünglichen BF16-Zeilen neu; im Rest bleiben approximierte Logits. Das Rescoring ist für die jeweilige Kandidatenzeile exakt. Es macht aber nicht die gesamte Sampling-Verteilung identisch und garantiert auch nicht, dass jeder tatsächlich beste Kandidat ins Screening gelangte. Die randomisierte Greedy-Oracle ist eine Regressionsprüfung, kein mathematischer Vollständigkeitsbeweis.13
Bei schmalen GEMMs ist die Launch-Geometrie nachrechenbar. Die grundlegende Split-K-Gridgröße ist . Mit , , und sind das 200 Blöcke, gegenüber 40 ohne Split-K. Für 800 Blöcke ist eine weitere Tile-Änderung nötig; Split-K fünf allein erzeugt sie nicht. Mehr Blöcke können die Occupancy verbessern, temporäre Teilresultate und die Reduktion erzeugen jedoch zusätzlichen Speicherverkehr. Ein schnelleres GEMM muss deshalb mit den tatsächlichen und dem passenden Cache-Zustand vermessen werden.
Lektion 5: Rückschritte in der Entscheidungsgrundlage behalten
Die aufschlussreichsten verworfenen Ideen zeigen, wo einfache Intuitionen scheiterten. Die folgenden Zeiten sind berichtete Mikrobenchmarks und lassen sich nicht einzeln aus der aggregierten CSV rekonstruieren.49
| Experiment | Beobachtung | Erkenntnis |
|---|---|---|
| GDN-Rank-Update/Chunk-Rewrite | Weniger Instruktionen, aber etwa 180 VGPRs; C32 204,5 statt 177,5 µs | Registerdruck senkte die Occupancy; weniger Instruktionen gewannen nicht |
| Synchronisierte HC-Split-K-Reduktion in einem Launch | 24–28 statt 6,1–6,4 µs bei kleinem M | Geräteweite Koordination kann mehr kosten als ein zusätzlicher Launch |
| Async Scheduling, erster AMD-Wiederholungslauf | C1 118,1 statt anfangs 131,6 Tokens/s | Eine Scheduling-Funktion kann die Zielanwendung verlangsamen |
| Probabilistischer Draft mit Blockverifikation | Etwas höhere berichtete Akzeptanz, unverändertes End-to-End-Ergebnis | Akzeptierte Tokens bestimmen nicht allein die Schrittzeit |
| Mixed-fast k39 | C32 2.405,1 statt k38 2.256,6 Tokens/s; max. TTFT 2,303 statt 0,876 s | Durchsatz und langsame Starts müssen gemeinsam bewertet werden |
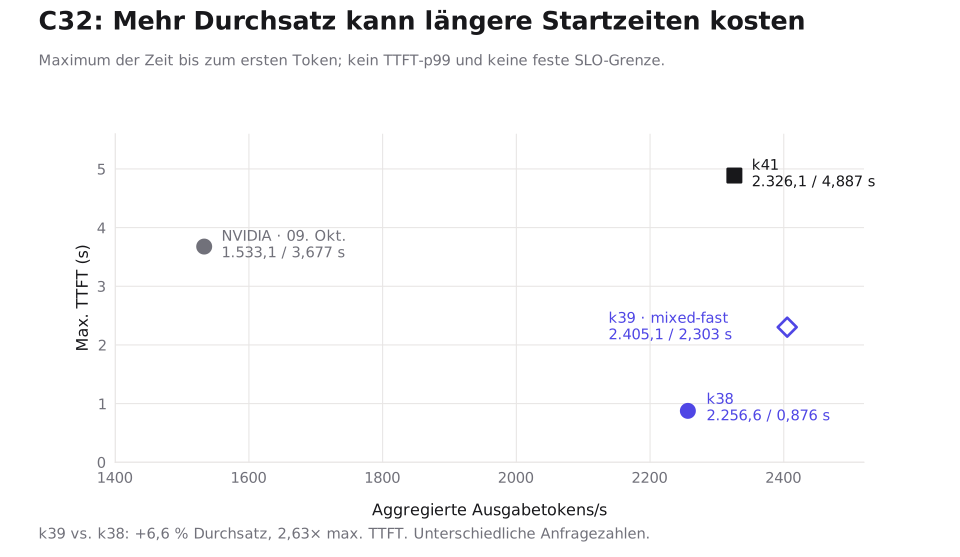
Die k39-Beobachtung gewinnt gegenüber k38 6,6 % Durchsatz und hat die 2,63-fache maximale TTFT. Das Maximum ist kein Perzentilschätzer und hängt von der Stichprobengröße ab: Diese C32-Beobachtungen haben 398 beziehungsweise 378 erfolgreiche Anfragen. Der spätere k41-Lauf erreicht 2.326,1 Tokens/s, aber eine maximale TTFT von 4,887 Sekunden. Das belegt eine Durchsatzbeobachtung, nicht die uneingeschränkte Verbesserung jeder Latenzmetrik. Grafik zur Abwägung öffnen.
Auch itl_p99_ms im Protokoll braucht einen präzisen Namen. Der Benchmark dividiert den Abstand eines Streaming-Chunks durch die Zahl der enthaltenen Token-IDs und trägt diesen Wert einmal pro Token ein. Speculative Decoding kann mehrere IDs gleichzeitig liefern. Das ist ein auf Burst-Größe normalisiertes Chunk-Abstands-p99, nicht der tatsächliche Ankunftsabstand jedes Tokens. k38 meldet 9,74/19,07/40,75 ms gegenüber 15,15/28,48/61,33 ms im NVIDIA-Kontrolllauf. Es ist ein nützlicher Proxy innerhalb desselben Benchmarks, kann aber die Dauer einer Mehrtoken-Burst-Lücke verdecken und belegt allein keine gleichmäßigere Ausgabe.
Was Korrektheits- und Produktionsprüfung belegen
Der öffentliche Code enthält Boot-Gates und mehrschrittige numerische Oracles. Sie decken akzeptierte Präfixlängen, Kopien an Cache-Grenzen und Graph-Replay ab. Das sind wertvolle Mechanismusprüfungen. Approximative Quantisierung und veränderte Reduktionen benötigen trotzdem Aufgaben-Evaluationen. Eine endliche erfolgreiche Oracle beweist nicht Korrektheit für jede mögliche Eingabe.
Die Kampagnennotizen berichten vollständige GSM8K-Scores von 0,9689 für AMD k38 und 0,9674 für NVIDIA sowie Tool-, Needle- und Bildprüfungen. Die nominelle Differenz entspricht etwa zwei Fragen von 1.319. Einzelvorhersagen und Evaluationsmanifeste fehlen in den gelieferten CSVs; es liegt daher kein gepaarter Signifikanz- oder Äquivalenznachweis vor. Auch der Score nach dem Produktionswechsel, 0,9583, liegt unter dem angegebenen Iterationsbereich von 0,9606–0,9689. Das verdient eine Untersuchung, statt es diesem Bereich zuzuordnen oder als numerisches Rauschen abzutun. „Keine HTTP-Fehler“, „Oracle bestanden“ und „Qualitätsparität“ beantworten unterschiedliche Fragen.
Die Notizen dokumentieren den Produktionswechsel am 11. Oktober und null fehlgeschlagene Probes. Ein Verfügbarkeitsprotokoll je Anfrage liegt nicht vor; null fehlgeschlagene Probes dürfen daher nicht zu null fehlgeschlagenen Produktionsanfragen werden. Die berichtete thermische Verschlechterung benötigt ebenfalls einen eingeschwungenen Test. In den vorliegenden kurzen Messreihen fehlen zeitlich zugeordnete Temperatur-, Takt- und Stromsamples. Ein gekühlter Langzeit-A/B-Test bleibt nötig, bevor diese Zahlen als dauerhafte Kapazität gelten.
Für den nächsten Lauf sind die nützlichen Aufzeichnungen konkret: Checkpoint- und Image-Hashes, vollständige Flags und Gates, wiederholbare Prompts, tatsächliche Aufwärm- und Restlaufzeiten, Prompt-/Ausgabelängen, Draft-Akzeptanz, Streaming-Burst-Größen, Anfragefehler, Qualitätsergebnisse und zeitlich abgestimmte Temperatur-/Leistungstelemetrie. Backend-Reihenfolge abwechseln und vollständige Messreihen wiederholen. Beim Start den tatsächlich gewählten Kernelpfad protokollieren und für Formen außerhalb des geprüften Vertrags den gewöhnlichen Pfad erhalten.
Die übertragbare Erfahrung lautet, Bytes und Abhängigkeiten zu verfolgen. Selten konsumierte Zustände später rekonstruieren, K/V bei passender Auswahl wiederverwenden, Metadaten nur innerhalb eines exakten Vertrags fusionieren und Präzision pro Projektion wählen. Die Baseline muss korrekt bleiben, die Latenzverteilung sichtbar. Die beobachteten AMD-Gewinne sind für dieses Deployment erheblich; ihren Wert liefern Mechanismus und nachprüfbare Messungen, nicht eine Hochrechnung auf einen ganzen GPU-Anbieter.
Daten und Primärquellen
Dem Artikel liegen das vollständige Messprotokoll, die Konfigurationsübersicht, das Audit-Ergebnis und der berichtete Kontext bei. Beide CSVs bewahren die gelieferten Bytes. scripts/plot-mi350p-campaign.py prüft die Zuordnung, berechnet Vergleiche und erzeugt mit Matplotlib 3.10.8 alle vier Grafiken in beiden Sprachen. Die folgenden Revisionslinks beschreiben die Implementierung; ihre berichteten Zeiten wurden für diesen Artikel nicht unabhängig neu gemessen.
Footnotes
-
flozi00, supplied
bench-history-amd-full-ledger.csvandamd-optimization-ladder.csv, observations 2026-10-08 through 2026-10-10. Downloadable copies and SHA-256 fingerprints in the audit output above. ↩ ↩2 -
flozi00, vllm-suffix-hybrid source tree at
8d09f300f4dc1542081c39abe7521f1e29508f5a, campaign implementation snapshot. ↩ -
AMD MI350P official specifications and NVIDIA RTX PRO 6000 Blackwell Server Edition official specifications, checked 2026-10-13. Capacity and CU values, not observed throughput. ↩
-
flozi00, DEEP-TECHNICAL-REPORT.md, prepared 2026-10-13. Selected reported environment, microbenchmarks, quality and cutover context are preserved in
campaign-notes.json; claims absent from the CSV are identified in the text. ↩ ↩2 -
Archived
abbench.py, request loop and metric denominators. ↩ -
Qwen, Qwen3.8-Flash-Next configuration at revision
de4b8e4d43b917e7706784d8bb445c9af86a3540. Architecture reference; the supplied endpoint aliases do not prove deployed weight identity. ↩ -
ROCm source patches, padding, hostcall, zero-buffer and source-anchor contracts. ↩
-
vLLM PR #46201, GPT-OSS/AITER padding cleanup; open when checked 2026-10-13. ↩
-
GDN deferred-commit and MFMA implementation and oracles. ↩ ↩2
-
Two-launch MoE routing, small-row dispatch and numeric contract. ↩
-
MXFP4 vocabulary screen and BF16 rescore, including retained approximate tail logits. ↩